
最近在研究让 Agent 快速读取代码库这件事。用 Vector RAG 切割代码会破坏函数调用关系和工程拓扑,这个问题绕不过去。所以调研了一圈基于图谱的方案,顺带搞清楚了 AST、Tree-sitter 和各框架之间的关系。
本文是这次调研的整理,主要聊两件事:Vector RAG 在代码场景的局限在哪,以及市面上的代码知识图谱框架各自适合什么场景。
1. Vector RAG 在代码场景的根本问题
目前主流的 RAG 方案是"文本切片 + 向量检索"。对于普通文档这没问题,但代码不一样。
代码的语义单元是函数、类、调用链,而不是"连续的一段文字"。按 chunk size 切割代码,极容易在函数体中间截断,导致大模型拿到的上下文是半截代码--函数签名有了,函数体没了,或者调用方有了,被调用方找不到。
更麻烦的是,代码里大量信息存在于调用关系中,而不是文本本身。一个函数被哪些地方调用、它依赖哪些模块、改动它会影响哪些链路--这些在向量空间里几乎无法表达。
所以问题不是 Vector RAG 不好,而是代码需要结构化理解,文本切片丢掉了最关键的拓扑信息。
2. 为什么代码图谱的底层是 AST
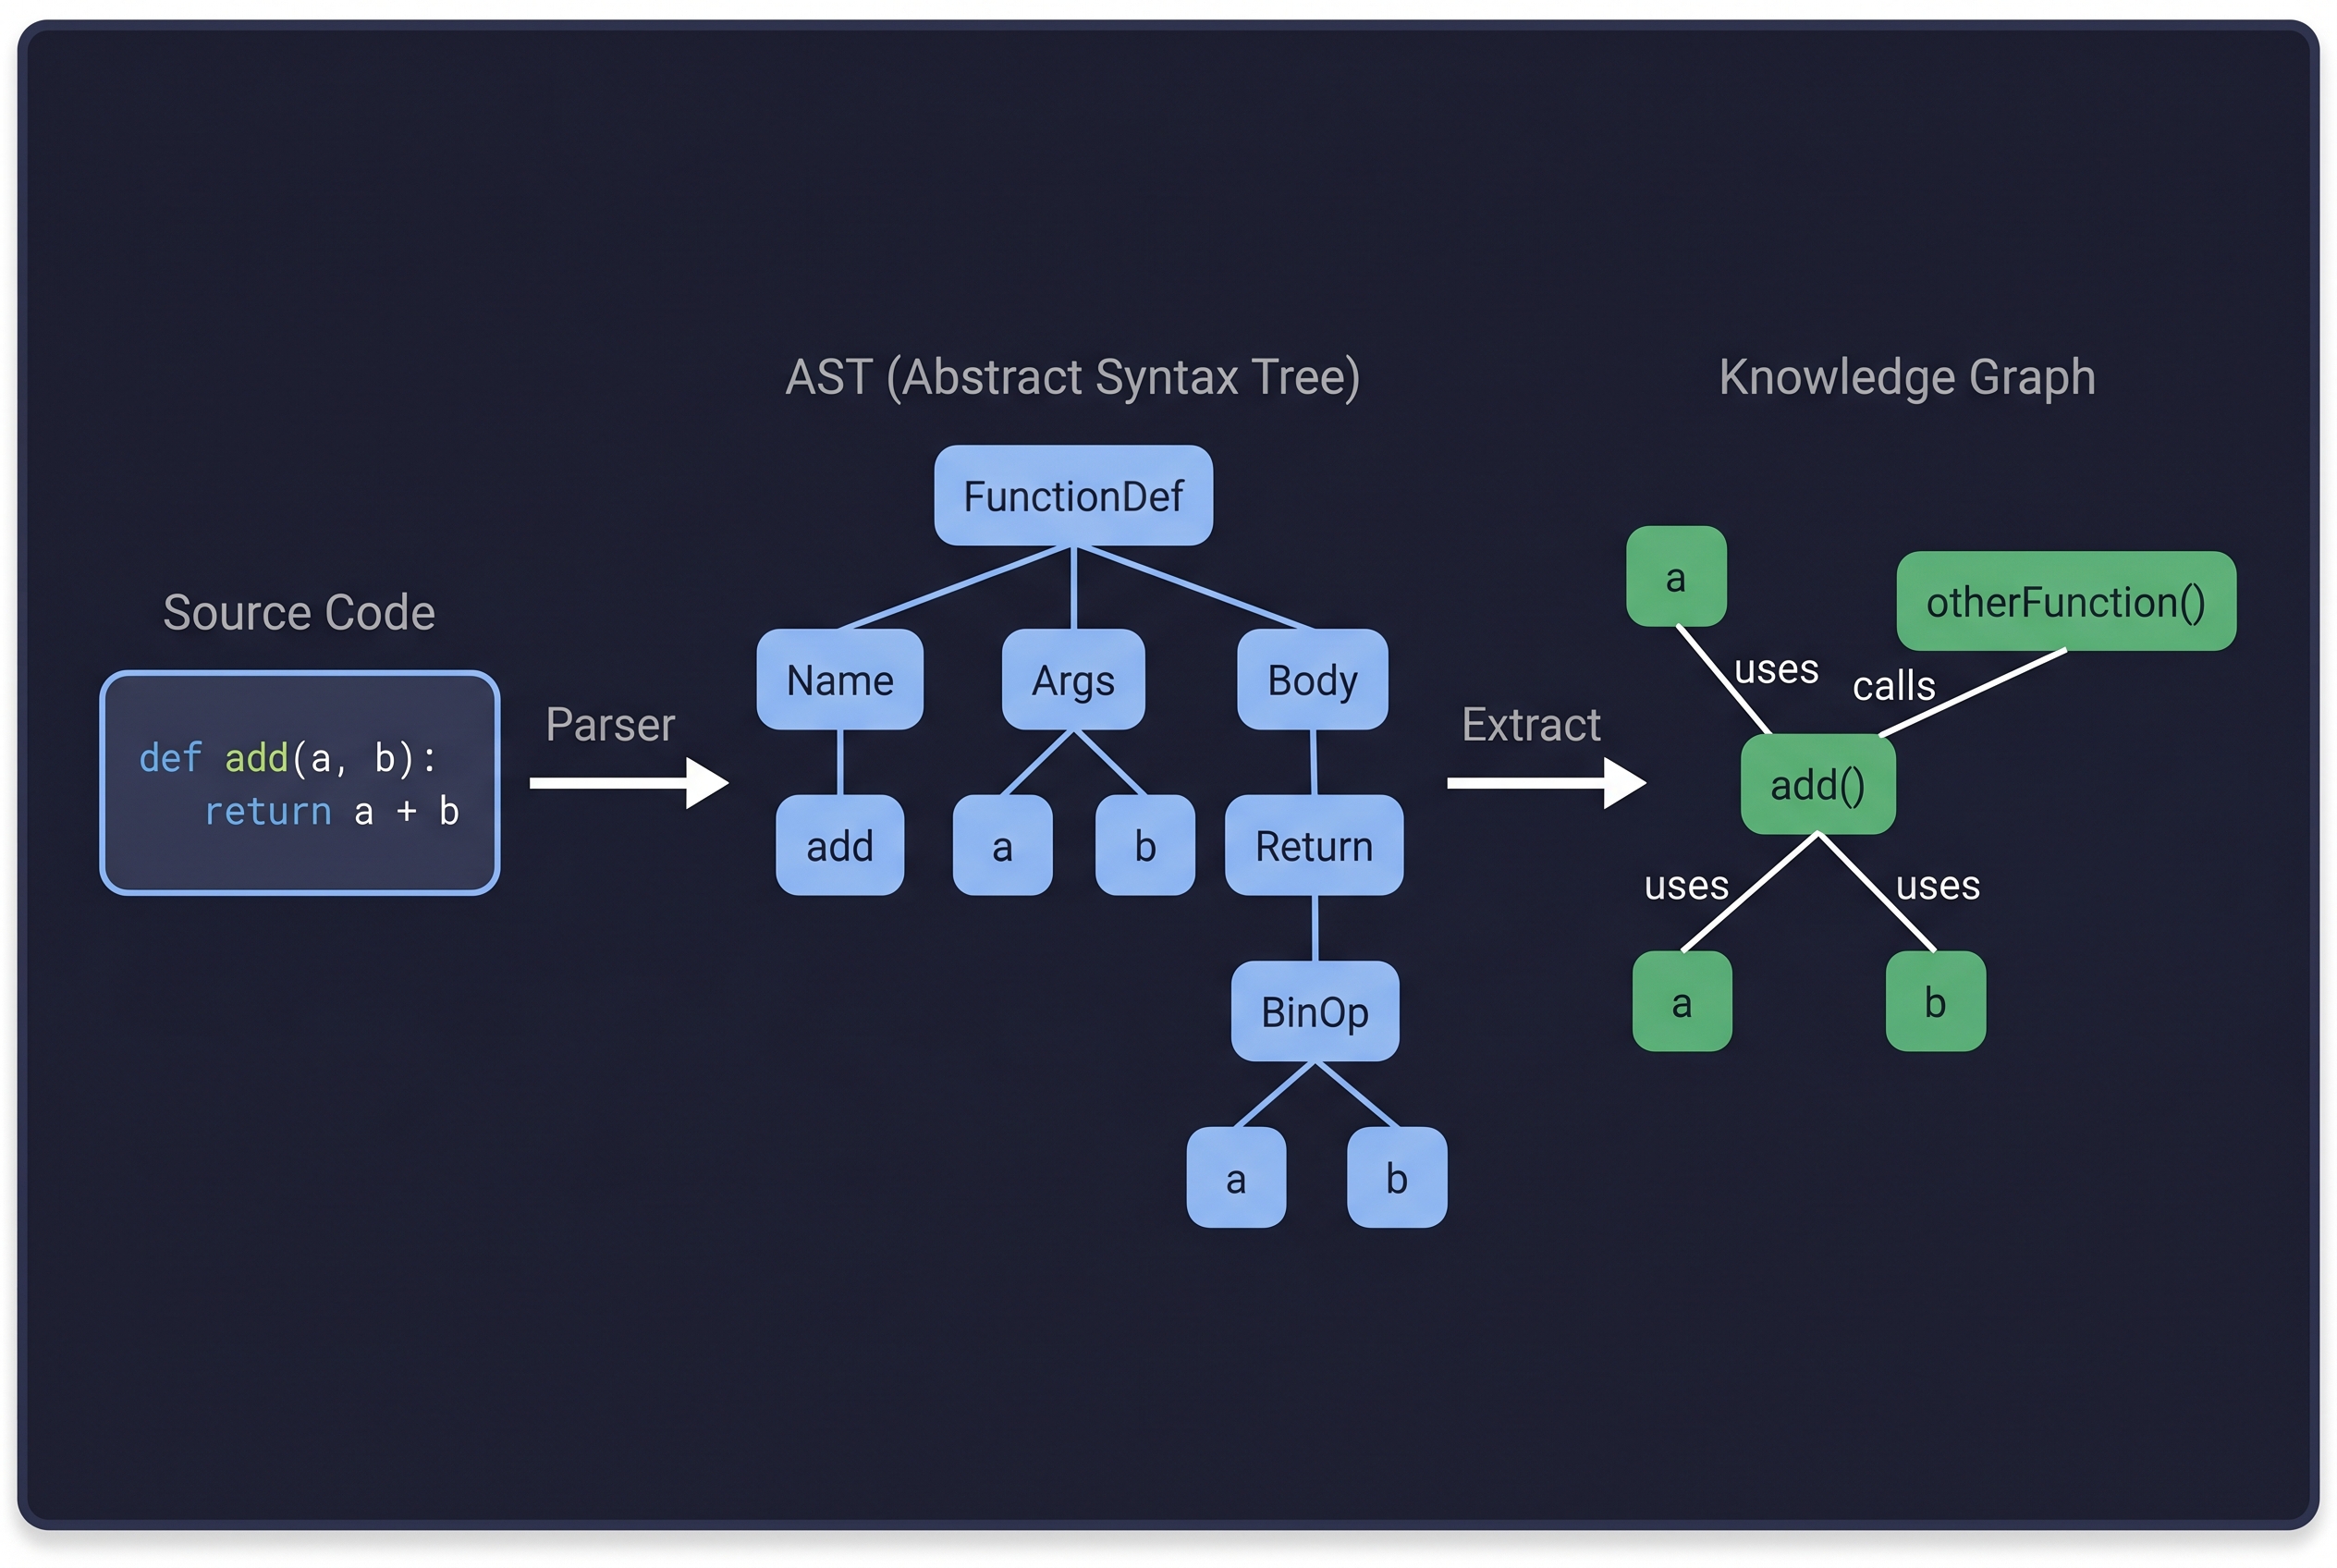
构建代码知识图谱,第一步是把代码变成结构化数据。这件事靠文本处理做不到--你没法从一堆字符串里可靠地找出"这个函数调用了哪些方法"。
AST(抽象语法树)解决的就是这个问题。代码经过解析器处理后,变成一棵树:每个函数、类、变量定义都是树上的节点,调用关系、导入依赖都是边。有了这张结构,才能从代码里提取图谱需要的原材料。
所以你看到的所有代码知识图谱框架,底层都离不开 AST--不是因为 AST 时髦,而是没有它就没有结构化的入口。
3. 为什么框架都选 Tree-sitter
AST 是概念,不是工具。每种语言有自己的解析器实现--Python 有内置 ast 模块,Java 有 JavaParser,各干各的。如果你要构建一个支持多语言的代码知识图谱,自己对接每种语言的解析器会是噩梦。
Tree-sitter 解决了这个工程问题:一套统一的 API,支持几十种语言的解析,输出格式一致。
需要说明的是,Tree-sitter 输出的不是严格意义上的 AST,而是 CST(具体语法树)。AST 会把括号、注释、空格这些"非语义"信息丢掉,只保留编译器需要的部分;CST 全保留,信息更完整,更适合做代码知识图谱。所以虽然很多框架文档混用"AST"这个词,但底层实际上用的是 CST。
除了统一多语言解析,Tree-sitter 还有三个让图谱框架偏好它的特性:
- 全保真(CST):保留源码中每一个字符,比传统 AST 更适合精确提取图谱节点
- 增量解析:代码变动时只更新受影响的子树,毫秒级响应,知识图谱可以跟着代码实时更新
- 容错恢复:有语法错误也不崩溃,尽量构建合理的树结构,适合处理写到一半的代码
这就是为什么 GitNexus、code-review-graph 等框架都选 Tree-sitter 做解析底座,而不是各自对接语言原生解析器。
顺带一提:Tree-sitter 本体是用 C 写的开源库,各语言(Python、Rust、Go、Node.js 等)都有对应的 binding。你在 Python 项目里 pip install tree-sitter 装的是 Python binding,底层跑的还是那个 C 核心。
4. 主流框架横评
这四个框架的底层都是静态解析,核心差异在于构建期是否依赖 LLM,以及面向的消费场景。
4.1 GitNexus:原生 MCP,Agent 直连
GitHub:abhigyanpatwari/GitNexus · ⭐ 35k+
定位:代码库深度解析的 Code Intelligence Engine。
构建期:0 LLM 依赖。完全靠 Tree-sitter 解析推导调用栈、导入关系、依赖链,底层用 LadybugDB(基于 KuzuDB 演进的嵌入式图数据库)做持久化存储。
暴露方式:CLI + MCP 是日常开发主力--索引完本地代码库后,直接作为 MCP 工具接入 Claude Code、Cursor、Codex、Windsurf 等 Agent。另有浏览器版 Web UI 供快速探索和演示,但受限于浏览器内存(约 5k 文件上限)。
适合场景:需要赋予 Agent 源码级的精细影响评估能力--"我改这个函数,会影响哪些下游调用?"这类问题,GitNexus 能给确定性的结构化答案。
4.2 Graphify:打通业务文档与代码
GitHub:safishamsi/graphify · ⭐ 44k+
定位:面向 AI 编程助手(Claude Code、Cursor 等)的多模态知识图谱扩展插件,能处理代码、SQL schema、文档、图片、视频,把散落的一切整合进同一张图。
构建期:强依赖 LLM。静态分析(Tree-sitter)负责提取代码结构,LLM 负责语义提取--读架构图、Docs 文档、PR 记录,把"业务概念"作为节点绑定到对应的"代码实现"节点上,支持增量更新和缓存以控制 token 消耗。
适合场景:接手一个零散资料的新项目、或者需要打通"代码 + 数据库 schema + 基础设施"的全局理解。它解决的是"这段代码为什么这样写",而不只是"这段代码怎么写的"。
4.3 Codebase-Memory:极致压缩,对抗超大仓库
GitHub:DeusData/codebase-memory-mcp · ⭐ 2.1k
定位:基于图聚类算法的低 Token 损耗图谱系统。
构建期:0 LLM 依赖。支持 155 种语言(Tree-sitter 核心解析 66 种,含社区扩展可达 155 种),用 Tree-sitter 解析构建持久化知识图谱,引入 Louvain 社区发现算法做模块级聚类,底层用内存 SQLite(RAM-first)实现极速查询。平均代码库毫秒级完成索引,Linux 内核(2800 万行)约 3 分钟,结构查询延迟低于 1ms。单静态二进制,零依赖,下载即用。
适合场景:超大代码库或对性能要求极高的场景。官方论文(arXiv:2603.27277)在 31 个真实项目上评测:83% 答题质量,token 消耗减少 10 倍,工具调用次数减少 2.1 倍。
4.4 code-review-graph:为 AI Code Review 定制的轻量工具
GitHub:tirth8205/code-review-graph · ⭐ 15.7k
定位:专为 AI 辅助代码审查场景设计的 Python 工具,比 GitNexus 更轻,上手门槛更低。
构建期:0 LLM 依赖。同样基于 Tree-sitter 解析代码,把函数、类、导入关系存进本地 SQLite,支持增量更新--代码有变动时只重新解析改动部分,不全量重跑。
核心机制:提交 PR 或 diff 时,工具遍历知识图谱,计算这次变更的 blast radius(影响半径)--自动识别所有受影响的调用方、依赖文件和相关测试。然后把这份精准的上下文打包喂给 AI Reviewer,大模型不需要扫全仓库,只看真正相关的部分,Token 消耗大幅下降,review 质量反而更高。
适合场景:日常开发和 PR Review 的 token 降本。官方数据:reviews 平均减少 8.2 倍 token(单项最低 6.8x),日常编码任务最高减少 49 倍。支持 24 种语言(含 Jupyter/Databricks Notebooks)。通过 MCP 接入 Claude Code、Cursor、Codex、Gemini CLI、Kiro 等主流 Agent,pip install code-review-graph 一行安装,自动检测并配置所有已安装的 AI 编码工具。
5. 选型结论与小结
四个工具定位清晰,不存在"哪个更好",只看你的场景:
| 场景 | 推荐方案 |
|---|---|
| 赋予 Agent 源码级影响分析和调用链溯源 | GitNexus(MCP 工具化优先) |
| 打通散落的业务文档与代码工程的全局理解 | Graphify(多模态语义融合) |
| 自研 AI 编码助手或处理巨型单体仓库 | Codebase-Memory(存储解耦 + 聚类压缩) |
| 日常 PR Review 自动化、快速落地 | code-review-graph(轻量 CI 插件) |
对于大多数团队来说,建议先跑通 code-review-graph,最快拿到收益;如果需要让 Agent 主动理解代码库(而不只是被动 review),再接入 GitNexus;如果发现大模型频繁问"这个设计为什么这样",再叠加 Graphify 的语义层。
Vector RAG 不是不好,只是不适合代码这种高拓扑密度的信息载体。代码知识图谱的核心价值,是把"梳理代码结构"这件事前置化、离线化,让大模型在推理时不需要靠肉眼扫文件来建立上下文。
AST/CST 解决了“怎么把代码解析成结构化数据”,Tree-sitter 解决了“怎么跨语言统一做这件事”,这四个框架再从不同角度解决了“怎么让 AI 消费这张图”——选哪个,取决于你的团队现在卡在哪一步。
这篇是基于公开文档和 GitHub 资料的调研整理,下一篇会针对几个框架做一个实测对比。
关注刘贺同学,下期见。
历史文章导入 · 历史文章编号:20260507-code-graph-theory · 写作日期 2026-05-07