
Peter(steipete)最近开源了 skill-cleaner,专门给 SKILL.md 做体检,配套发了条吐槽:写 skill 的人喜欢把使用说明写成一本书,每次对话全都加载进 context。
我跑 skill-cleaner 算了下 Claude Code 实际加载的 SKILL.md:总共 115 个,其中自己散落在几个 git 仓库里积累的有 104 个,plugin 自带的只有 11 个。真正耗 context 的不是 plugin,是自己几个月攒下来的私人 skill 库——每次开 session 都加载进 system reminder,用没用过不影响占 context。该清理一波了。
一、主流的写法是什么
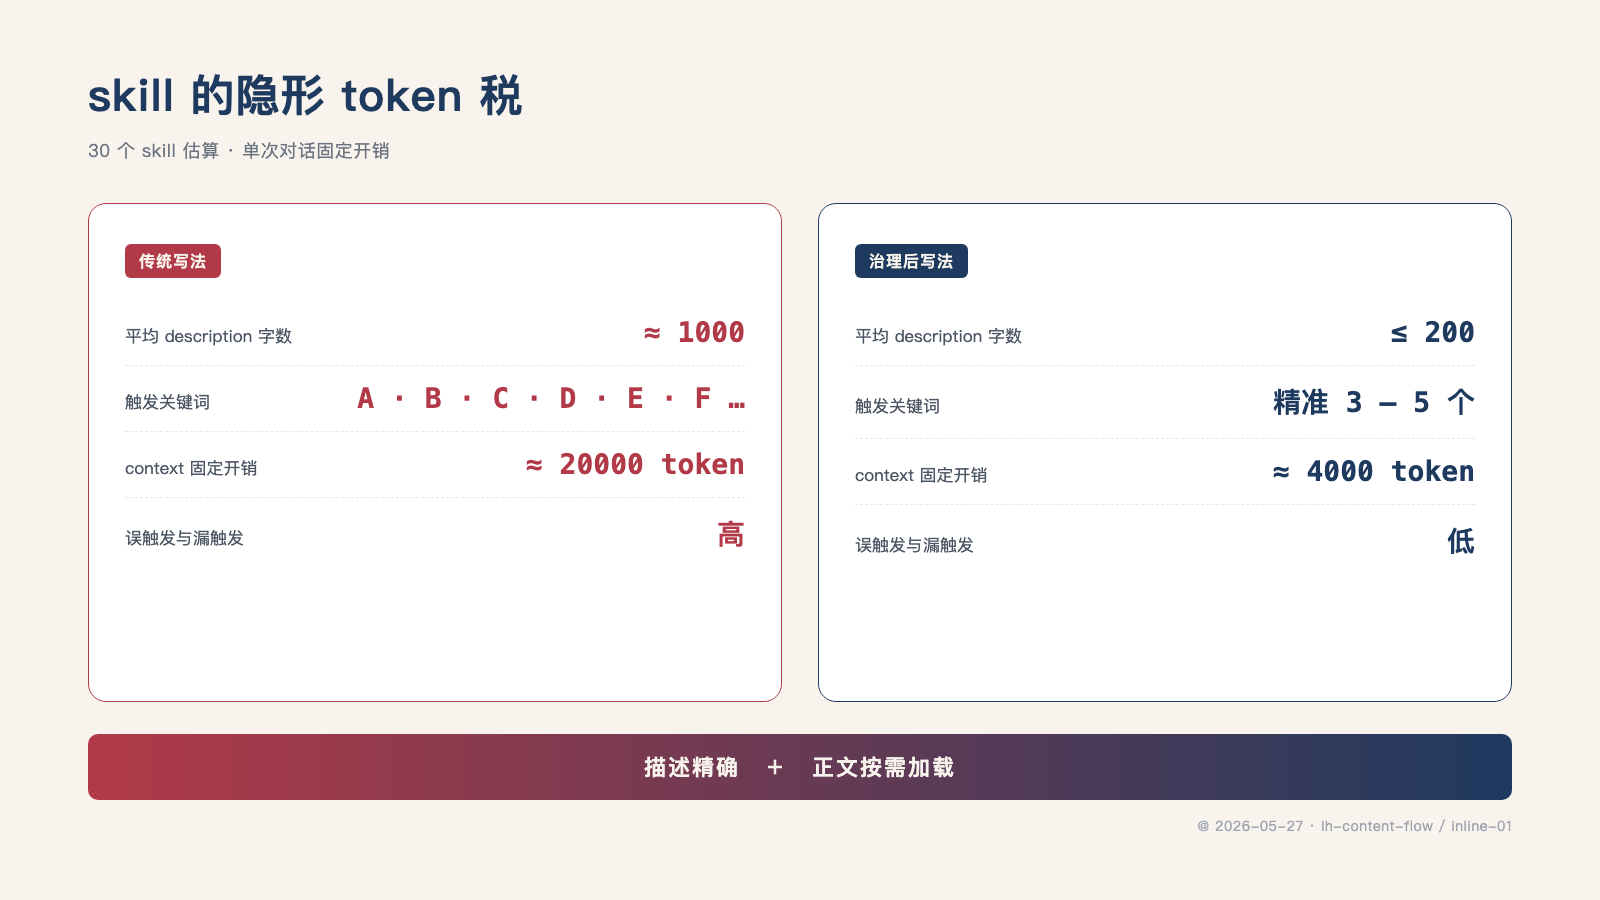
现在写 skill 的思路是宁多勿少。description 字段往死里堆触发词,「当用户说 A、B、C、D、E、F……时使用」;正文恨不得把所有边界情况、反例、踩过的坑全塞进去。逻辑很合理:写得越详细,agent 越不容易判断错。
社区也在比谁的 skill 写得多、谁覆盖的场景广,这成了一种隐性的能力证明。我自己也是这个路线的执行者,最长的一个 SKILL.md 居然有 700 行。
二、我的看法
skill 不是越多越聪明,描述也不是越长越保险。它是有重力的,每一个字都在偷偷向 context 收税。
agent 加载 skill 列表时,每个 skill 的 description 都得读进上下文做匹配。115 个 SKILL.md description 加起来 2.9 万字符 / 约 8,700 token——单论占比只占 200K context 的 4% 左右,没有想象的夸张。但 100+ 个 skill 给路由判断带来的杂音是另一个维度:agent 在这么多 description 里找信号,描述写糊或者关键词撞车都会导致误触发、错触发。
正确的方向不是「写得详尽」,而是「描述精确、正文按需加载」。description 解决「这个 skill 是不是该用」,正文解决「真要用时怎么用」,两件事得分开。
三、我们可以怎么做
第一步,把所有 SKILL.md 的 description 砍到 200 字以内。只保留触发判定必需的关键词和场景边界,使用细则全部移到 reference 子文档。单纯搬家,不删功能。
第二步,跑 skill-cleaner 的预算审计量化每个 skill 的 token 成本,高于 P90 的逐一审。我一跑就发现描述写最长的几个反而是 OpenAI 官方策展的 figma 一套(design / diagram / library,都写到 800 字)——这种 plugin 自带的"重描述"是顺手能优化的低垂果实。
第三步,砍掉自己写的不再用的 skill。这是真正的大头:我自己 104 个 skill 里,三个月没触发过的至少四五个,留着只浪费触发判断的精力。一并审下每个 skill 的 description——长得离谱的、关键词撞车的都收敛一下。
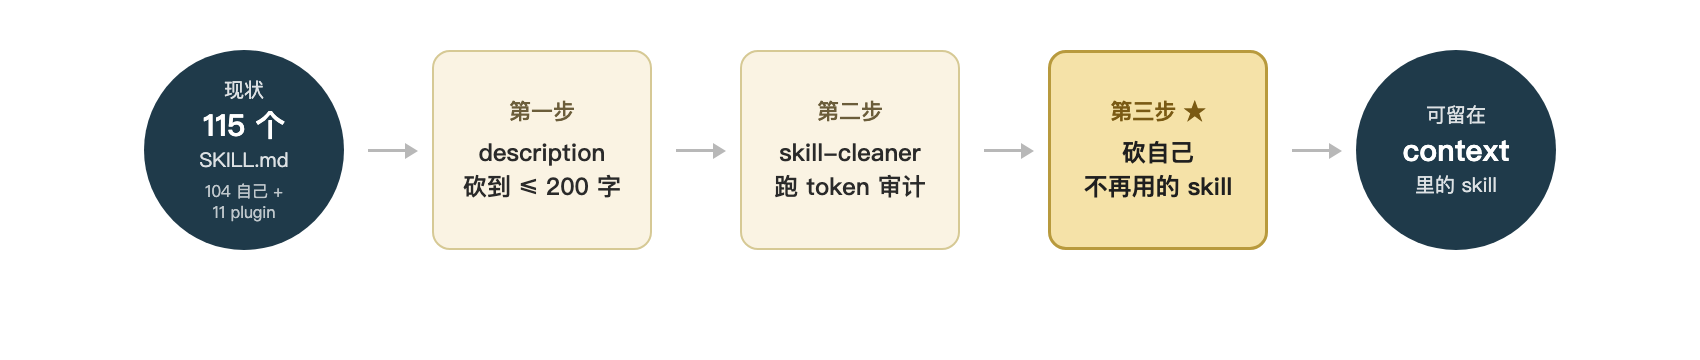
这套思路不是必须照搬,核心就两件事:先量化、再删减。skill-cleaner 也不是必装——它本质是一把"秤",称完之后该删该改还得你自己定。大家可以按自己的目录结构尝试一下,先把账算清楚,再决定动哪几个。
历史文章导入 · 历史文章编号:20260527-skill-bloat-cleaner · 写作日期 2026-05-27