
最近在做票据识别,发票、回单都有,PNG、PDF 混着来。要本地、离线跑——财务票据不想传第三方云,也不想按调用量付费。本地能跑的有传统专项 OCR(PaddleOCR、RapidOCR 这些)和自部署 VLM(PaddleOCR-VL、MinerU、Marker)两条,VLM 这次依赖冲突没装通,所以这篇先把又小又快、CPU 就能跑的传统专项 OCR 测明白。
我拿 13 张真实票据,纯 CPU(Apple M2 Pro)和 GPU(NVIDIA A10)各跑一轮,13 张共 69 个关键字段逐项打分。结论先放这儿:PP-OCRv6 和 RapidOCR 准确度打平、都能字段全对,真正要权衡的是速度和部署,取决于你有没有 GPU。
一、实测结果
准确度(字段命中率)和单张稳态耗时如下(耗时取一张代表样本连跑 ≥3 次、扔掉首次冷启动再取平均):
| 引擎 | 字段命中率 | CPU 单张 | GPU 单张 | 说明 |
|---|---|---|---|---|
| PP-OCRv6 | 1.00(69/69) | 7.15s | 0.18s | 输出干净无空格噪音;GPU 提速约 40× |
| RapidOCR | 1.00(69/69) | 0.62s | 1.83s | 输出含空格需清洗;默认装的是 CPU 版 onnxruntime 没启用 GPU,故 GPU 反而慢 |
| Docling | 0.94(65/69) | 3.07s | — | 中等,部分扫描件不稳定 |
| markitdown / pdftotext | 0.87(53/61) | 秒级 | — | 仅抽带文字层 PDF,对图片返空 |
| pymupdf4llm | 0.77(47/61) | <0.1s | — | 纯文本抽取,带文字层 PDF 最全 |
| Tesseract(chi_sim) | 0.71(49/69) | 0.14s | — | 快,但中文票据基本认不出,排除 |
(文本抽取器只跑带文字层的 PDF,图片回单返空,所以它们的分母是 61 不是 69。)
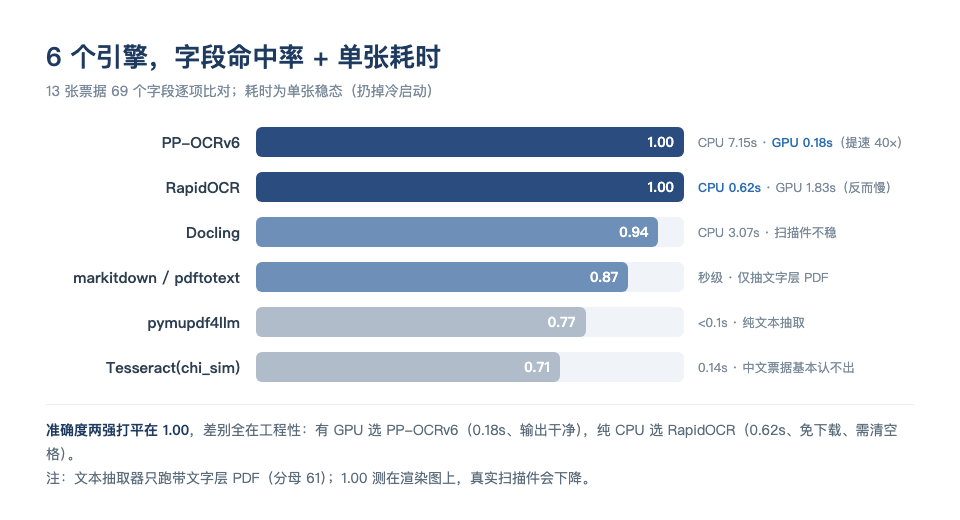
两强打平在 1.00,差别只在工程性(速度、要不要清空格),具体见上图。有个反常的点值得说:RapidOCR 在 CPU 上 0.62s,挪到 GPU 上反而变成 1.83s——默认装的 rapidocr_onnxruntime 是 CPU 版、没启用 CUDA,根本没走显卡,加上模型小,传显存、起 kernel 的开销比省下的计算还多。小模型搬 GPU 不一定更快。
还得说明一句:这 1.00 是在「带文字层渲染成的图」上测的,相对干净;真实扫描件有模糊、倾斜、印章遮挡,分数会明显往下掉。别拿 1.00 当承诺,它只说明「清晰票据上不丢字段」,不是「永远不会错」。
二、选型建议
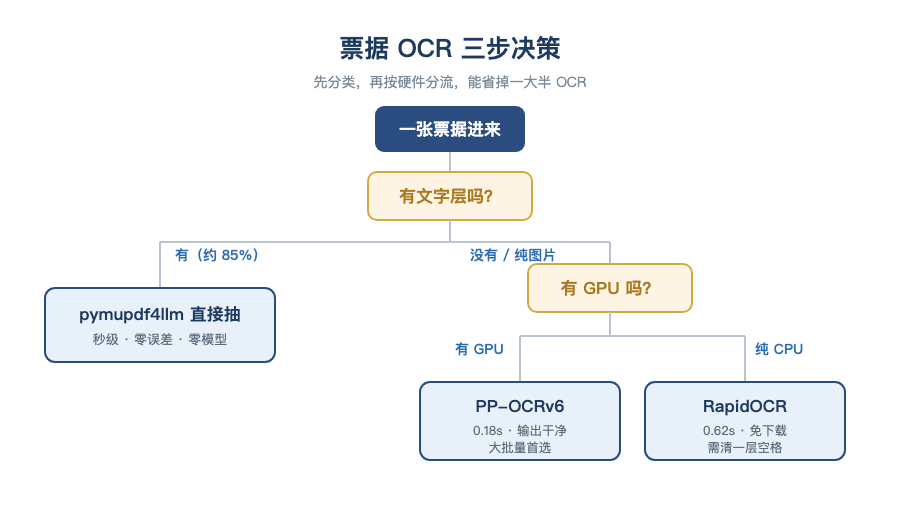
- 先分类:PDF 有文字层直接抽(pymupdf4llm,秒级零误差零模型),没有才上 OCR——我这 13 张里 11 张带文字层,先分类能省掉一大半 OCR。
- OCR 按硬件选:有 GPU 上 PP-OCRv6,纯 CPU 用 RapidOCR(记得清一层空格)。
- 金额字段必须二次校验:大小写金额交叉核对,任何引擎都不能盲信。
三、评测方法:让运动员和裁判分开
评测集是 7 张发票(增值税电子普通发票、各省公益捐赠票据)加 6 张银行回单(建行、中行、平安),其中 2 张回单是纯图片,必须 OCR 才能读。
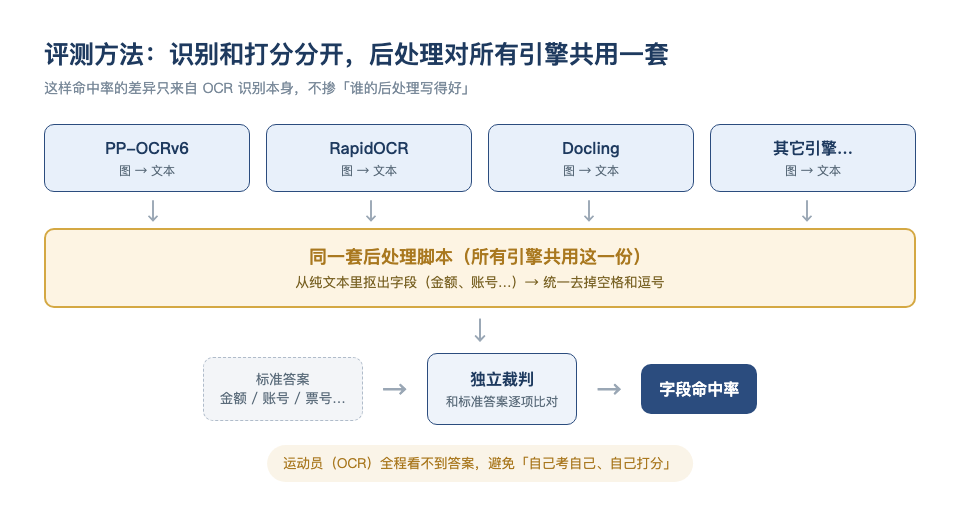
方法上我特意把识别和打分分开,免得引擎自己又当运动员又当裁判。OCR 引擎只做一件事,图转文本,不自评、看不到答案。
OCR 吐出来是一整段没结构的文本,得先从里面把字段(金额、账号这些)抠出来才能比对,这一步叫后处理。坑在于:如果每个引擎配不同的后处理脚本,最后命中率的差异就分不清是「OCR 谁认得准」还是「谁的后处理写得好」。所以我让所有引擎都过同一份后处理脚本,比对前再统一去掉空格、逗号(RapidOCR 爱带空格、PP-OCRv6 不带,不抹平的话 RapidOCR 会因为空格平白丢分,可那不是它认错字)。这样剩下的命中率差异,就只反映 OCR 识别本身。
打分是另一套独立脚本,拿预测字段和标准答案逐项比对算命中率,确定、可复现、没有幻觉。标准答案是每张票据的关键字段(金额、账号、票号、单位、日期):带文字层的票据,PDF 里本就存着正确文字,直接拿来当答案,再渲染成图喂给 OCR;2 张纯图票据的答案靠人工核对。
测试环境两套:CPU 机是 Apple M2 Pro(10 核 / 32GB / 纯 CPU 无独显),GPU 机是 NVIDIA A10(23GB 显存 / Ubuntu,阿里云 ECS)。设备直接决定哪些模型能跑、跑多快。
附录:评测里用到的开源项目
历史文章导入 · 历史文章编号:20260617-local-ocr-finance · 写作日期 2026-06-17