
一个需求,Agent 上午就把代码写完了。
到了下午,它还卡在需求确认、代码评审、测试环境和发布审批上。代码确实快了,交付却没有快多少。
这可能是很多团队接下来都会遇到的问题:AI 没有消除研发瓶颈,只是把瓶颈从“写代码”推到了“判断这份代码能不能上线”。
Anthropic 最近发布了一篇《The AI-Native SDLC Playbook》。SDLC 即“软件开发生命周期”(Software Development Life Cycle),通常包括规划、设计、构建、测试、部署和维护六个阶段。这篇文章讨论的,就是如何把 AI 重新放进这套流程。
我读完后,觉得真正值得借鉴的不是照搬文中的文件名和 Claude 配置,更不是机械地为每个阶段配一个 Agent,而是三件事:
- 编码提速,不等于交付提速。
- 阶段之间要交接可验收的产物,而不是继续堆聊天记录。
- Agent 可以走到生产门口,但不能自己批准自己进去。
一、编码变快,瓶颈转向规划、测试和部署
生成式 AI 最先显著压缩的是 Build:原型更快,代码生成更快,修改也能并行推进。
但问题值不值得做、需求边界清不清楚、测试是否覆盖真实场景、谁来批准上线,这些工作不会自动变快。它们以前被“写代码很慢”遮住了,现在反而成了最显眼的堵点。
所以 AI-native SDLC 的重点,不是继续压缩编码时间,而是重做阶段之间的交接和验收。
Anthropic 并没有另起一套生命周期,仍然是规划、设计、构建、测试、部署和维护六个阶段。变化的是阶段之间的交接方式:
意图形成规格,规格形成实施计划;代码必须附带测试证据,通过评审和发布授权后进入生产;生产事故再转成新的需求与评测用例。
原文把前三份制品写成 intent.md、spec.md 和 plan.md。文件名并不重要,重要的是每个阶段都留下一个可验收、能被下一阶段读取的结果。
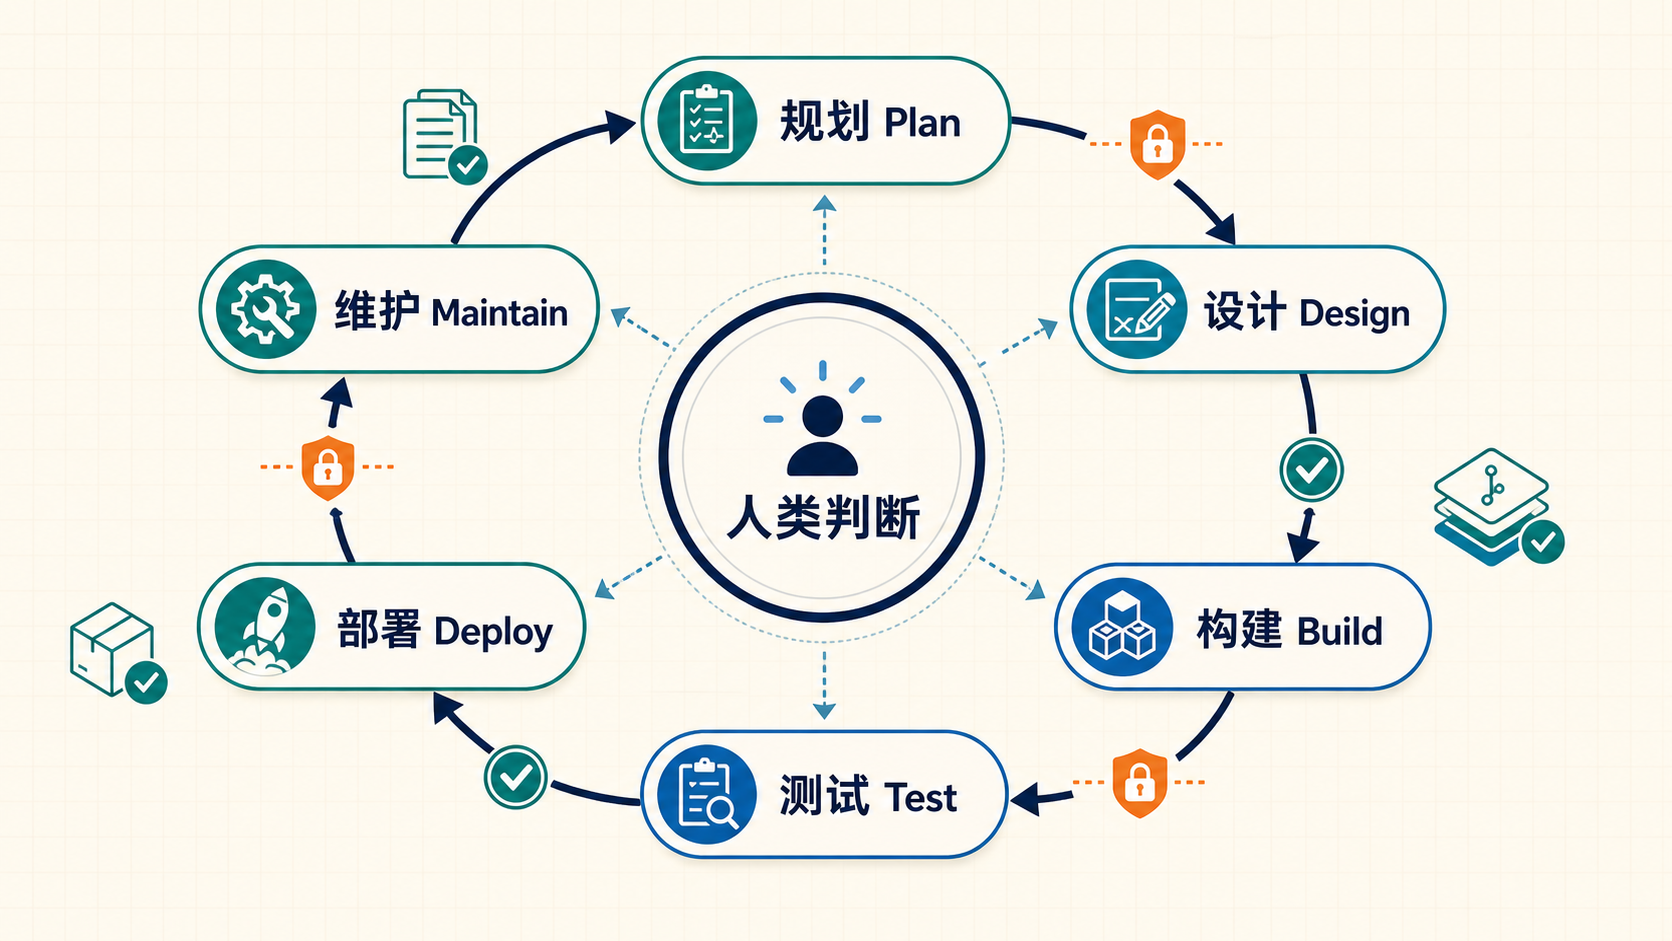
二、六个阶段,分别要交付什么
1. Plan:先把问题说清楚
先明确用户、问题、目标、约束和不做什么,再让产品负责人接受最终意图。效果既要看从首次讨论到提交 intent.md 的时间,也要看意图接受率和开工后的返工次数。
2. Design:让组织规则进入规格
规格不只有功能,还要带上安全、合规和用户体验规则。每类制品应指定一个事实源;如果 Jira、Figma 等已有权威记录,仓库保存记录 ID、链接或对应提交版本,避免产生互相漂移的副本。
3. Build:先批准计划,再允许写代码
Agent 先读取仓库并给出实施计划,工程师检查依赖、风险和影响范围后再允许实现。CLAUDE.md 和 Skill 负责指导;不能违反的规则交给 Hook、测试、Lint 和分支保护。
并行也不是越多越好。多个 Agent 可以放进独立 worktree,但上限通常不是机器能跑多少会话,而是工程师能可靠评审多少结果。大家都在改同一批文件时,串行可能更省时间。
4. Test:Agent 说“完成”不算证据
Agent 要拿到真实的构建、测试、浏览器和截图反馈。修 Bug 时先写稳定失败的测试,再修实现;必要时由一个未参与生成的 verifier 独立复核。“完成”至少要附构建、测试和 Lint 结果。
普通测试之外,原文还建议用 20~50 个真实任务建立持续评测,在 CLAUDE.md、Skill、Hook 等 Agent 配置变化时运行,防止配置改动让整体效果退化。
5. Deploy:让 Agent 走到生产门口
AI 可以初审 PR、分析 CI 和准备发布材料,人负责意图、风险和生产授权。写代码的 Agent 不能批准自己的变更,关键代码仍由 code owner 审批。
能力逐级开放:先只读诊断,再允许创建 PR;开发环境可以更自主,生产环境保留人工门禁;令牌要短期、最小权限,回滚要提前演练。
一句话概括:Agent 可以一直行动到生产门口,但不能自行跨过去。
6. Maintain:让事故重新进入生命周期
监控、工单或定时任务可以触发 Agent,但异常检测应由确定性脚本完成,Agent 负责解释和提案。低风险事件只记录,中风险只读诊断,高风险动作只能进入 PR 审批门禁或执行预先批准的 Runbook。
真实事故要变成新的意图和永久评测用例:
事故 → 诊断 → 新意图 → 实现 → 验证 → 发布 → 永久评测
三、我的解读:从三层控制到落地
如果把原文再抽象一层,我认为可以归纳成三个控制层:
- 建议层:
CLAUDE.md、Skill 和参考文档,告诉 Agent 应该怎么做。 - 执行层:Hook、测试、Lint、分支保护和独立验证,负责机械判断和阻断。
- 权限层:沙箱、凭据隔离、环境白名单和人工批准,限制错误可能造成的影响。
写了安全 Skill,不等于已经限制网络和凭据;加了沙箱,也不等于代码已经满足业务需求;Agent 自己评审自己,更不等于完成了职责分离。
三层控制只有放进具体的交付场景才有意义,也不需要一开始就铺满整个研发流程。所谓最小闭环,是先选一个高频、边界清楚的需求,让它完整走过“意图—规格—计划—代码与测试—评审发布—结果回流”,再用同类需求验证这套流程能否重复运行。
落地时不必照搬文中的文件名和 Claude 配置,可以先做三件事:
- 明确每个阶段的交付物、验收标准和事实源;
- 接入一条可自动判断的门禁,保留人工合并和生产授权;
- 把返工和生产事故转成后续评测用例。
效果应看返工、评审耗时和变更失败率,而不是生成了多少代码。原文所说的“数周缩到数小时”,也不应直接当作确定收益。
如果团队还没有稳定的测试和回滚机制,就不应先让 Agent 自动上线。AI-native 不是取消上线前检查和上线后止损,而是把这些保障变成 Agent 必须经过的门禁;否则只会让错误更快进入生产。
我的总结
AI-native SDLC 没有让人的工作消失,只是把人的注意力从逐步操作,上移到了定义问题、接受规格、判断证据和授权生产。
代码越来越便宜之后,真正稀缺的不再是“把代码写出来”,而是知道该写什么、怎么证明它是对的,以及什么时候允许它进入生产。
这才是 Anthropic 这篇 Playbook 最值得带走的部分。
原文:Louis Claxton,《The AI-Native SDLC playbook》,Anthropic,2026-08-21
历史文章导入 · 历史文章编号:20260826-ai-native-sdlc · 写作日期 2026-08-26