
Anthropic 删除了 Claude Code 80% 以上的系统提示词,在 Claude Opus 5、Claude Fable 5 这类模型的编码评测中,没有观察到可测量的性能下降。
这些内容并非全部丢掉了。Anthropic 把原来混在系统提示词和 CLAUDE.md 里的规则、流程与记忆,分别交给 Skills、Auto Memory、工具接口和验证机制。
顺着这个变化,我更关心两个实际问题:长期记忆从 CLAUDE.md 拆出去后,到底放在哪个目录?团队成员共同开发一个项目时,这些记忆又怎么共享?
一、Claude 为什么敢删掉 80%
Anthropic 给的原因很直接:Claude Code 被过度约束了。
系统提示词、CLAUDE.md、Skills 和用户请求里,经常同时存在冲突的要求。比如一边写着“酌情保留文档”,另一边又写着“不要添加注释”。Claude 通常仍能猜到用户真正想要什么,但它必须先花时间消解这些冲突,再决定怎么做。
官方举的例子很具体。旧系统提示词要求:“默认不写注释,不写多段 docstring,除非用户明确要求,否则不要创建规划、决策或分析文档”。新规则只剩一句:“编写与周围代码一致的代码,匹配它的注释密度、命名和惯用风格”。
前者试图提前枚举所有情况,后者只给判断依据。过去模型判断力不够,强规则是必要的取舍;新模型能读周围代码自己判断,那些为旧模型准备的防呆规则反而开始产生副作用。
但删掉约束不等于放弃约束。Anthropic 做的是重新分配。
二、规则没有消失,只是换了位置
官方原文列了六组变化,背后只有一个原则:每类信息应该待在最适合它的位置。
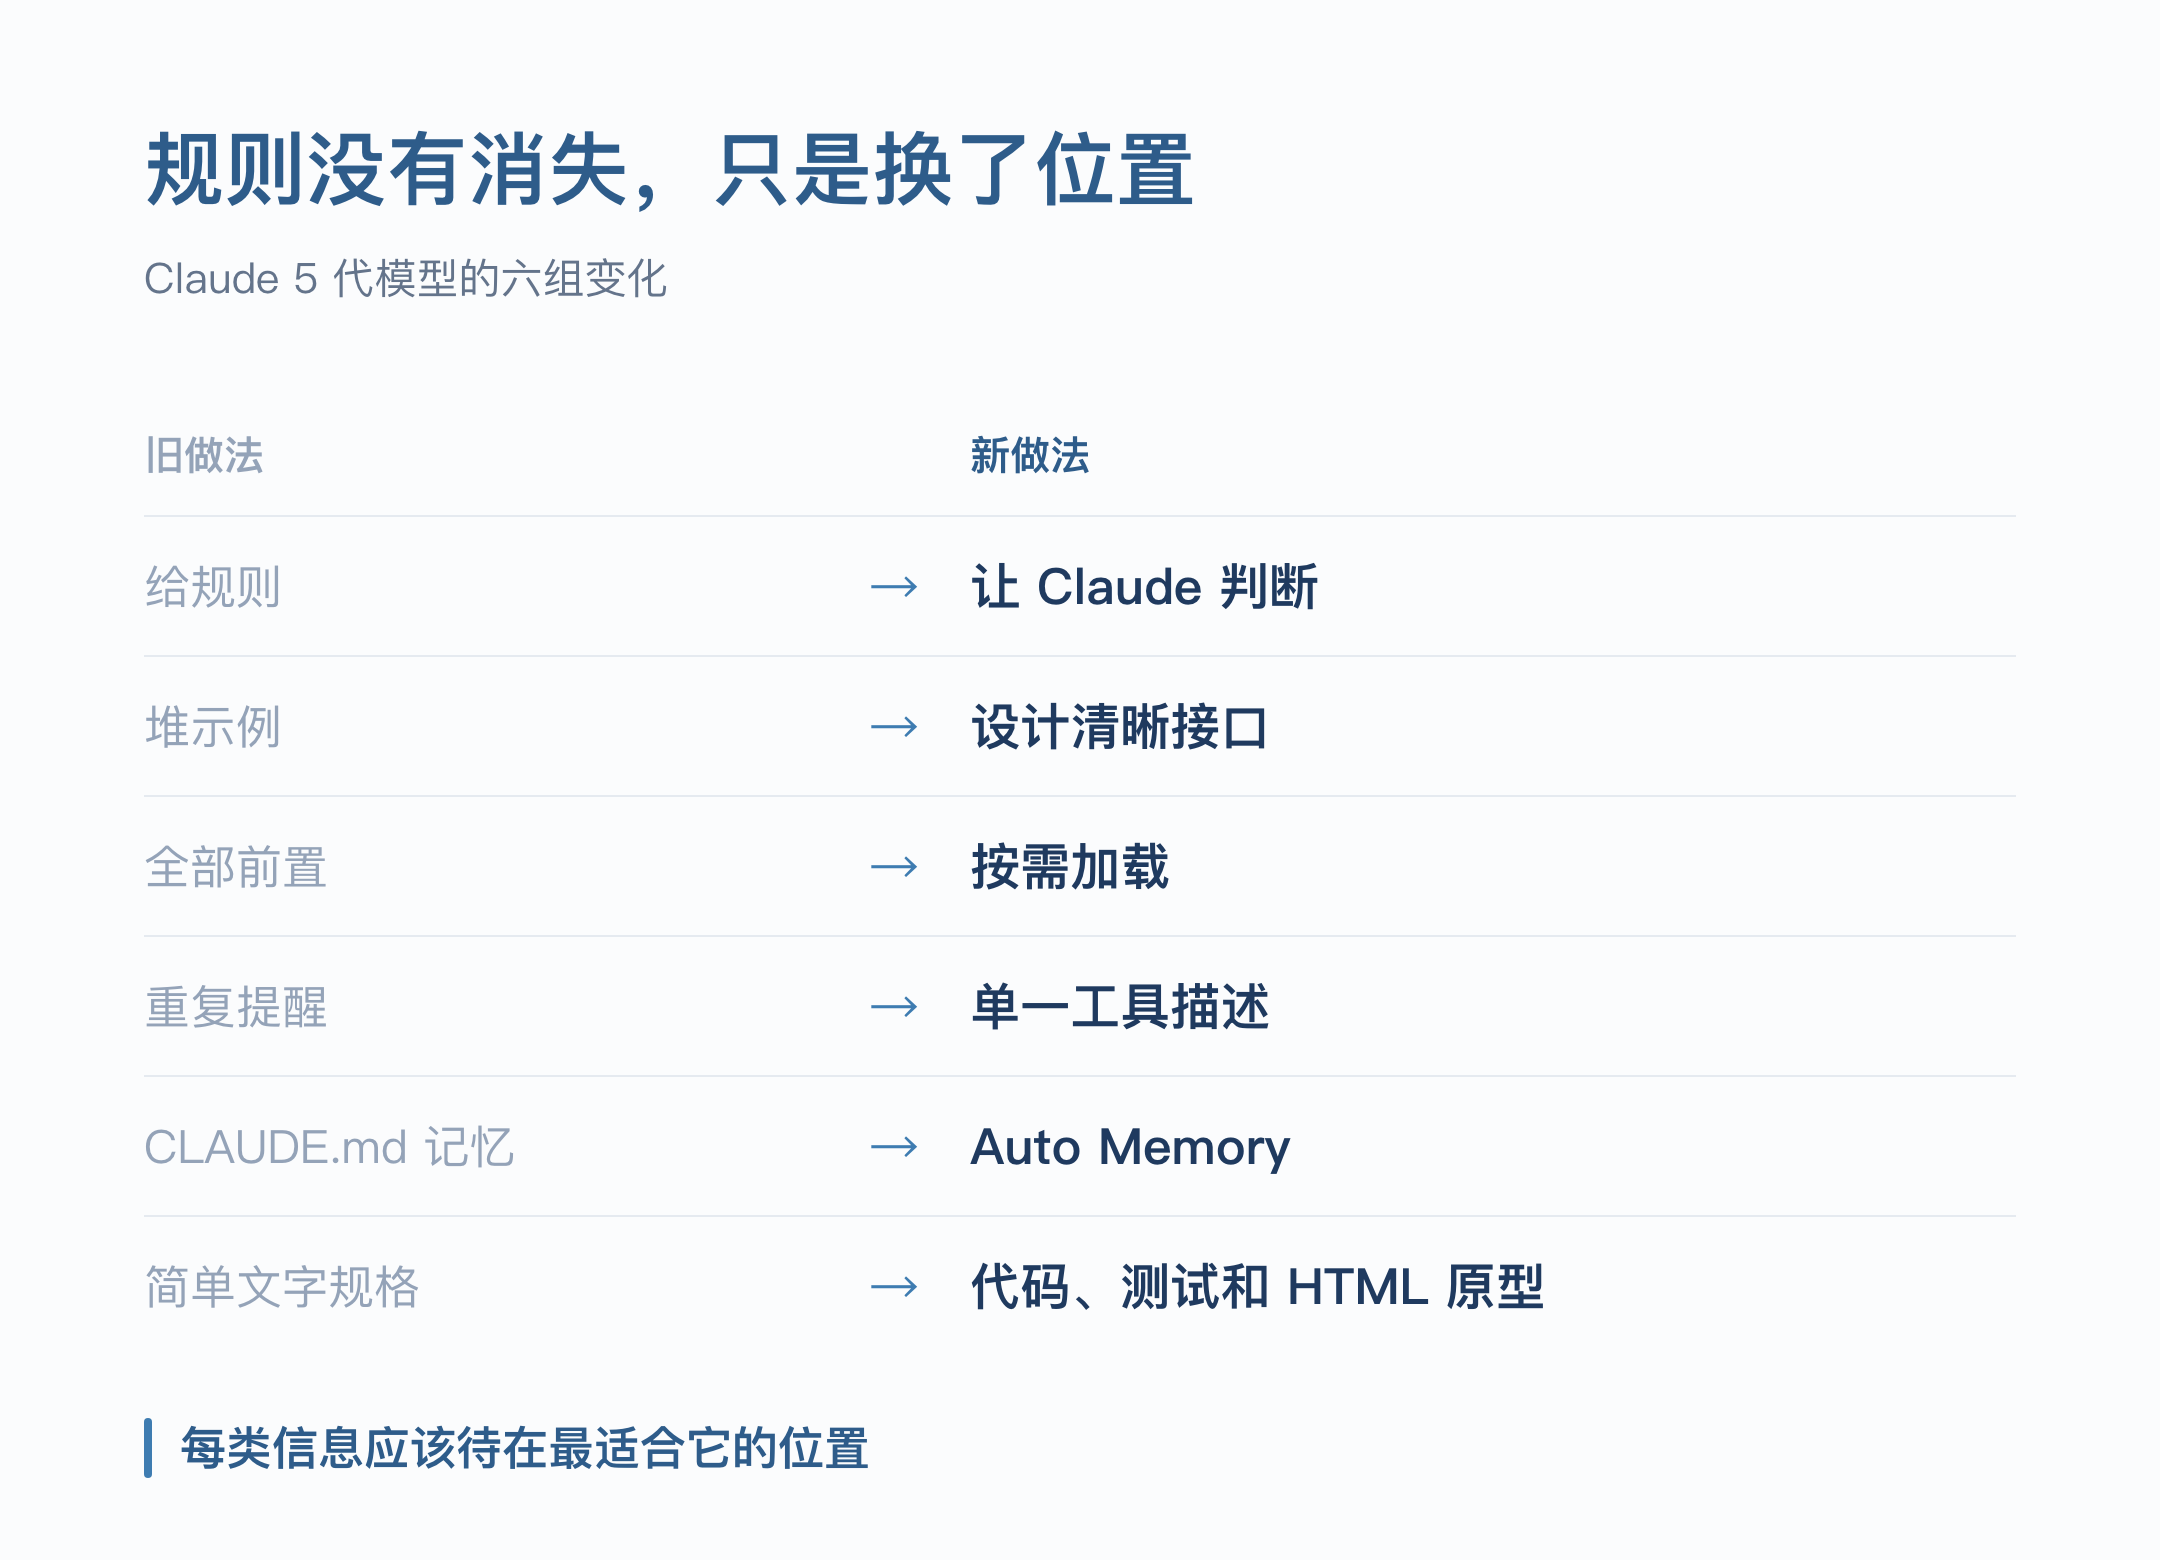
能从代码仓库直接看出来的内容,让 Claude 自己读取。工具参数能表达的限制,写进枚举、Schema 和接口。只在特定任务里用的流程,放进 Skill 按需加载。能自动判断对错的要求,写成测试、Lint 或 CI。删除数据、对外发布、付款、生产操作这类高风险动作,交给权限和审批机制。
这比在 CLAUDE.md 里反复写“请务必确保”可靠得多。
系统提示词仍然重要。如果你在构建自己的 Agent Harness,系统提示词应该重点描述它运行在哪个产品中、承担什么职责。模型能从现场推断、或者可以由其他机制约束的内容,不必继续常驻。
CLAUDE.md 也应该保持克制:简短说明仓库用途,主要篇幅留给代码库里的特殊陷阱,不要重复 Claude 查看文件系统就能知道的事实。复杂的验证说明拆成 Verification Skill,CLAUDE.md 只保留入口。
所以 80% 不是一条可以照抄的压缩目标。原文用的词是 rightsize,调整到合适大小。一个原本只有几百字、全是权限边界的文件,硬删 80% 只会让系统失忆。
三、CLAUDE.md 和 Auto Memory 怎么分工
Claude Code 以前鼓励把工作记忆写进 CLAUDE.md,现在它提供了独立的 Auto Memory。项目级记忆通常位于 ~/.claude/projects/<项目标识>/memory/,其中 MEMORY.md 是索引,其他主题拆成独立 Markdown 文件。
这里的关键不是目录变了,而是信息性质变了。CLAUDE.md 更像项目契约,保存人明确制定、所有相关任务都应该遵守的稳定规则;Auto Memory 更像 Claude 的个人工作笔记,保存它在使用过程中学到的经验。
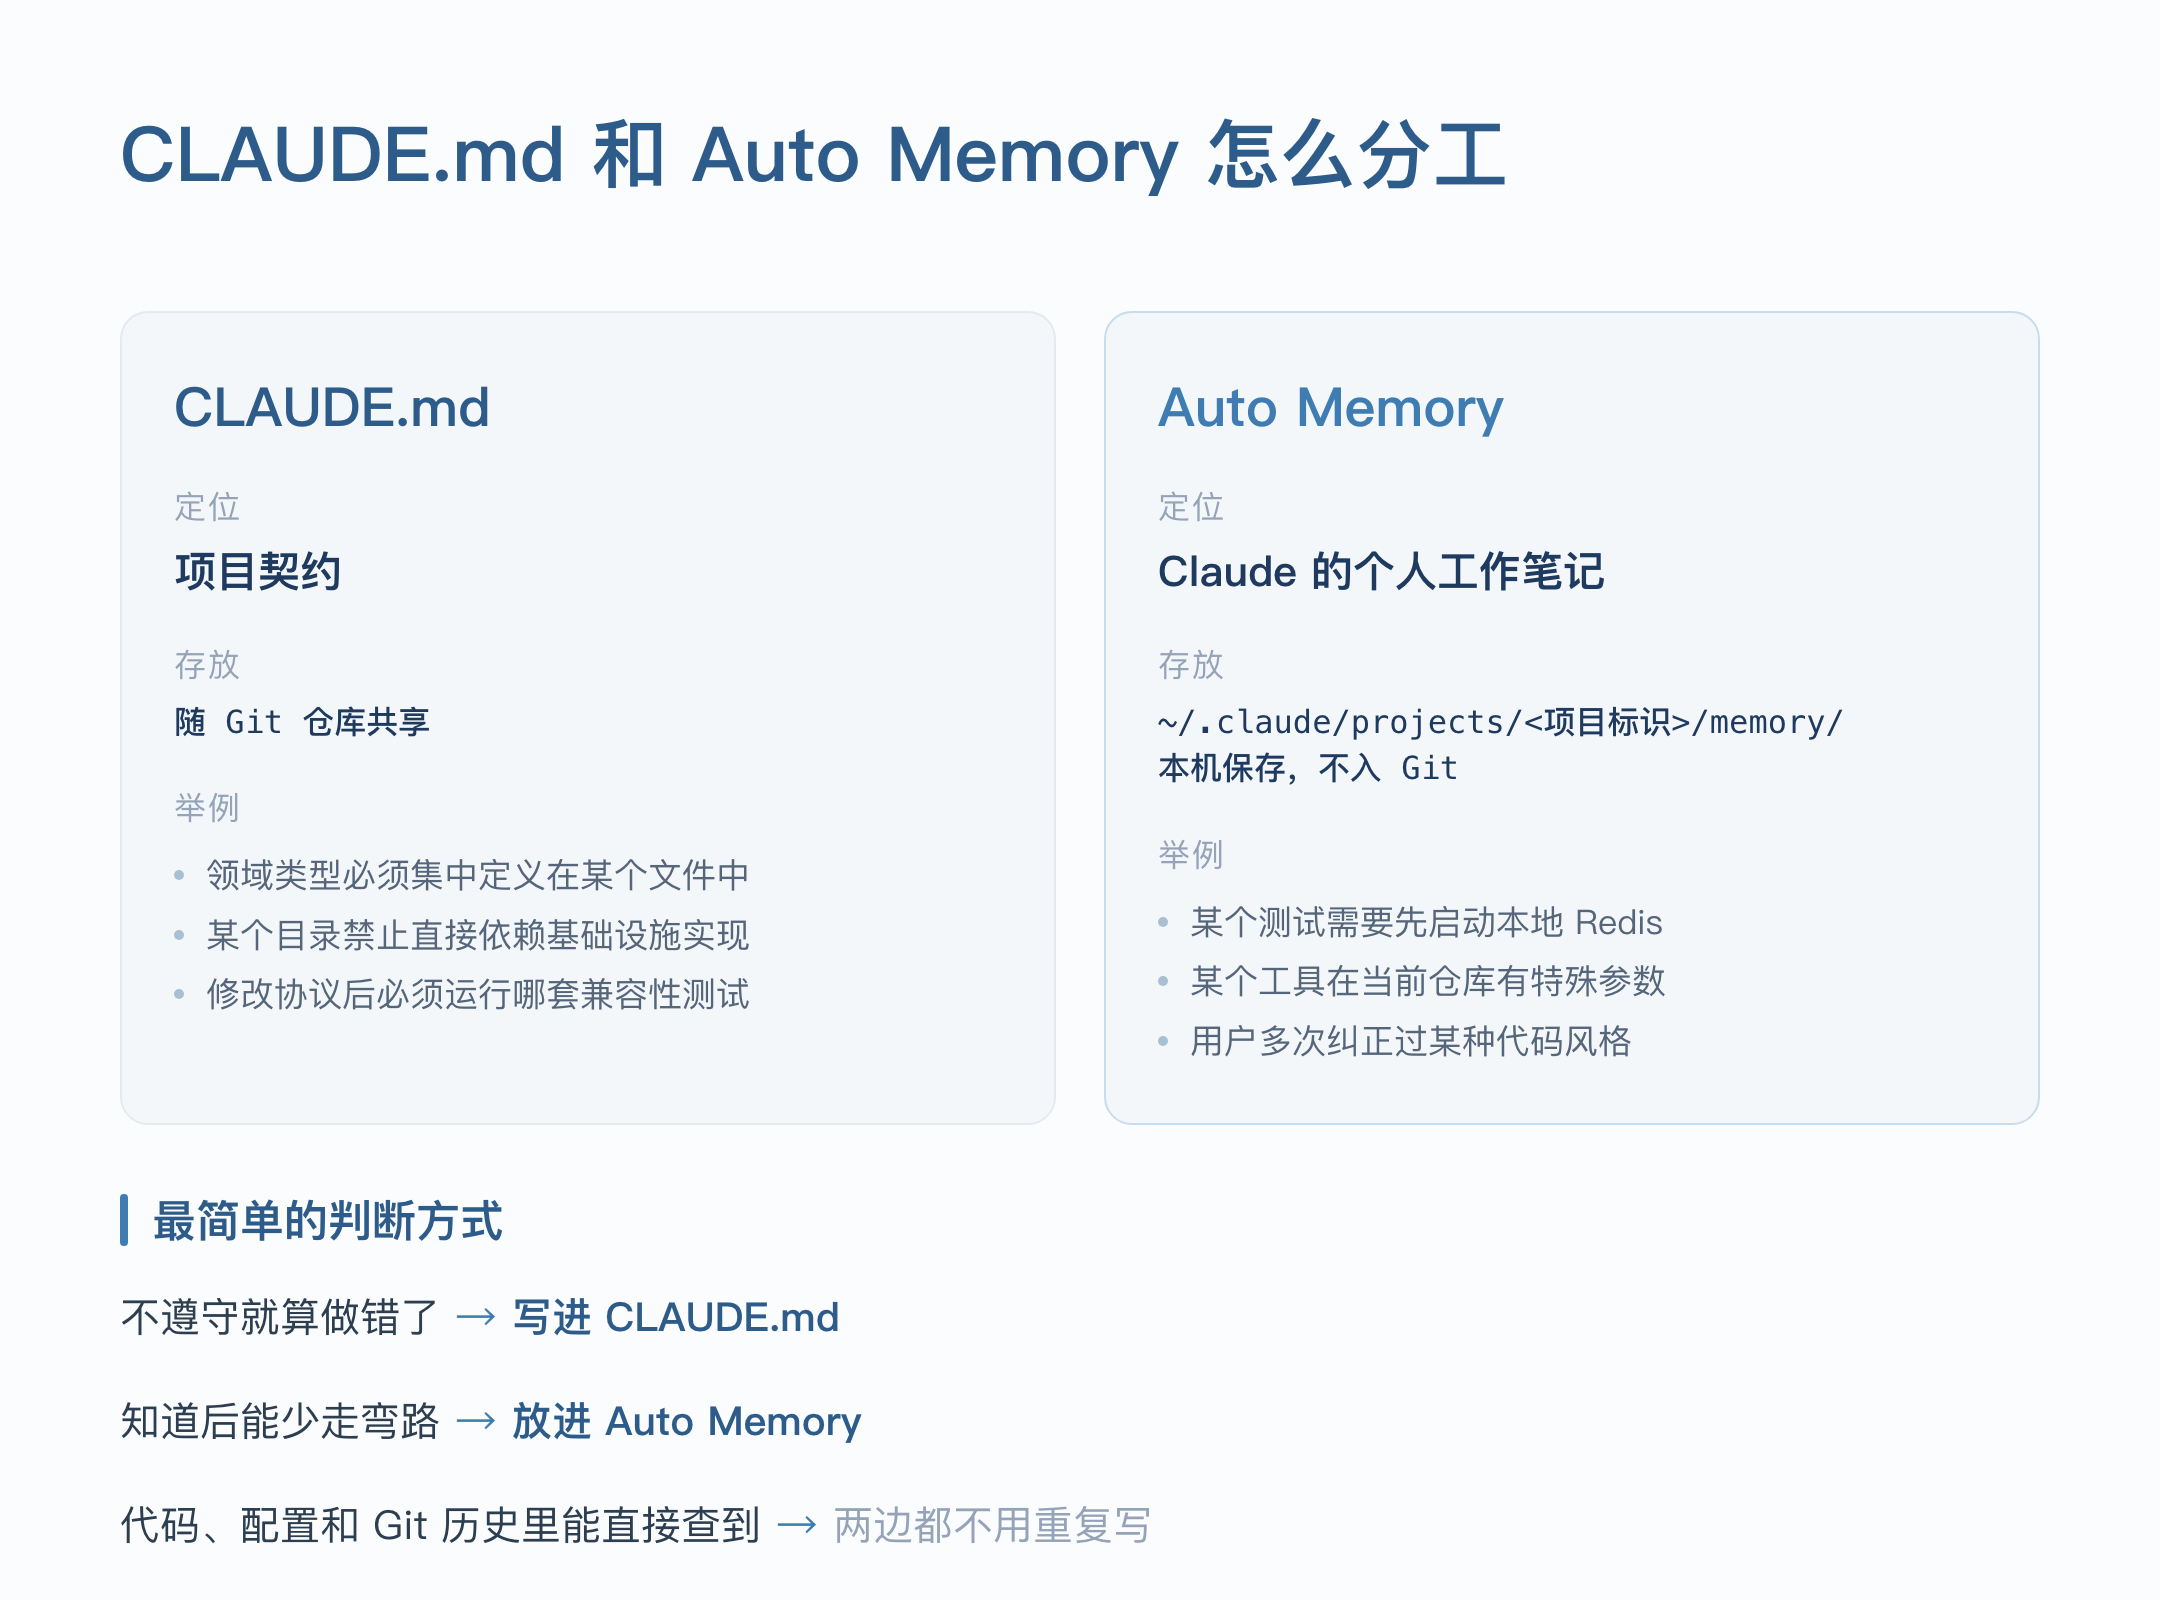
这一步解决的是个人与单个 Agent 的长期协作,却还没解决团队协作。
四、再往上延伸,就是团队知识库
Auto Memory 默认保存在每位开发者自己的电脑上,不属于项目 Git 仓库。张三的 Claude 排查出一个隐藏问题并写入本机 Memory,李四拉取同一个项目后,他的 Claude 默认不会知道这条经验。
这不是缺陷,而是合理边界。个人记忆里可能包含本机路径、临时绕过方案、尚未验证的推断、个人偏好,甚至已经过期的结论。直接把整个 memory 目录同步给团队,等于把个人工作痕迹和项目事实混在一起。团队需要的不是同步所有记忆,而是让有价值的经验经过验证后再升级。
代码仓库能解决单个项目的知识共享,但团队通常不只维护一个仓库。某个支付回调的验签规则属于具体项目,放在仓库里很合适;“第三方回调问题应该按哪些步骤取证”“为什么高风险操作必须保留人工确认”“多个服务如何统一做故障复盘”,这些经验跨项目复用,再塞进每个仓库的 CLAUDE.md 就会重复。
这时候需要团队知识库。它和 Auto Memory、仓库文档正好构成三层。
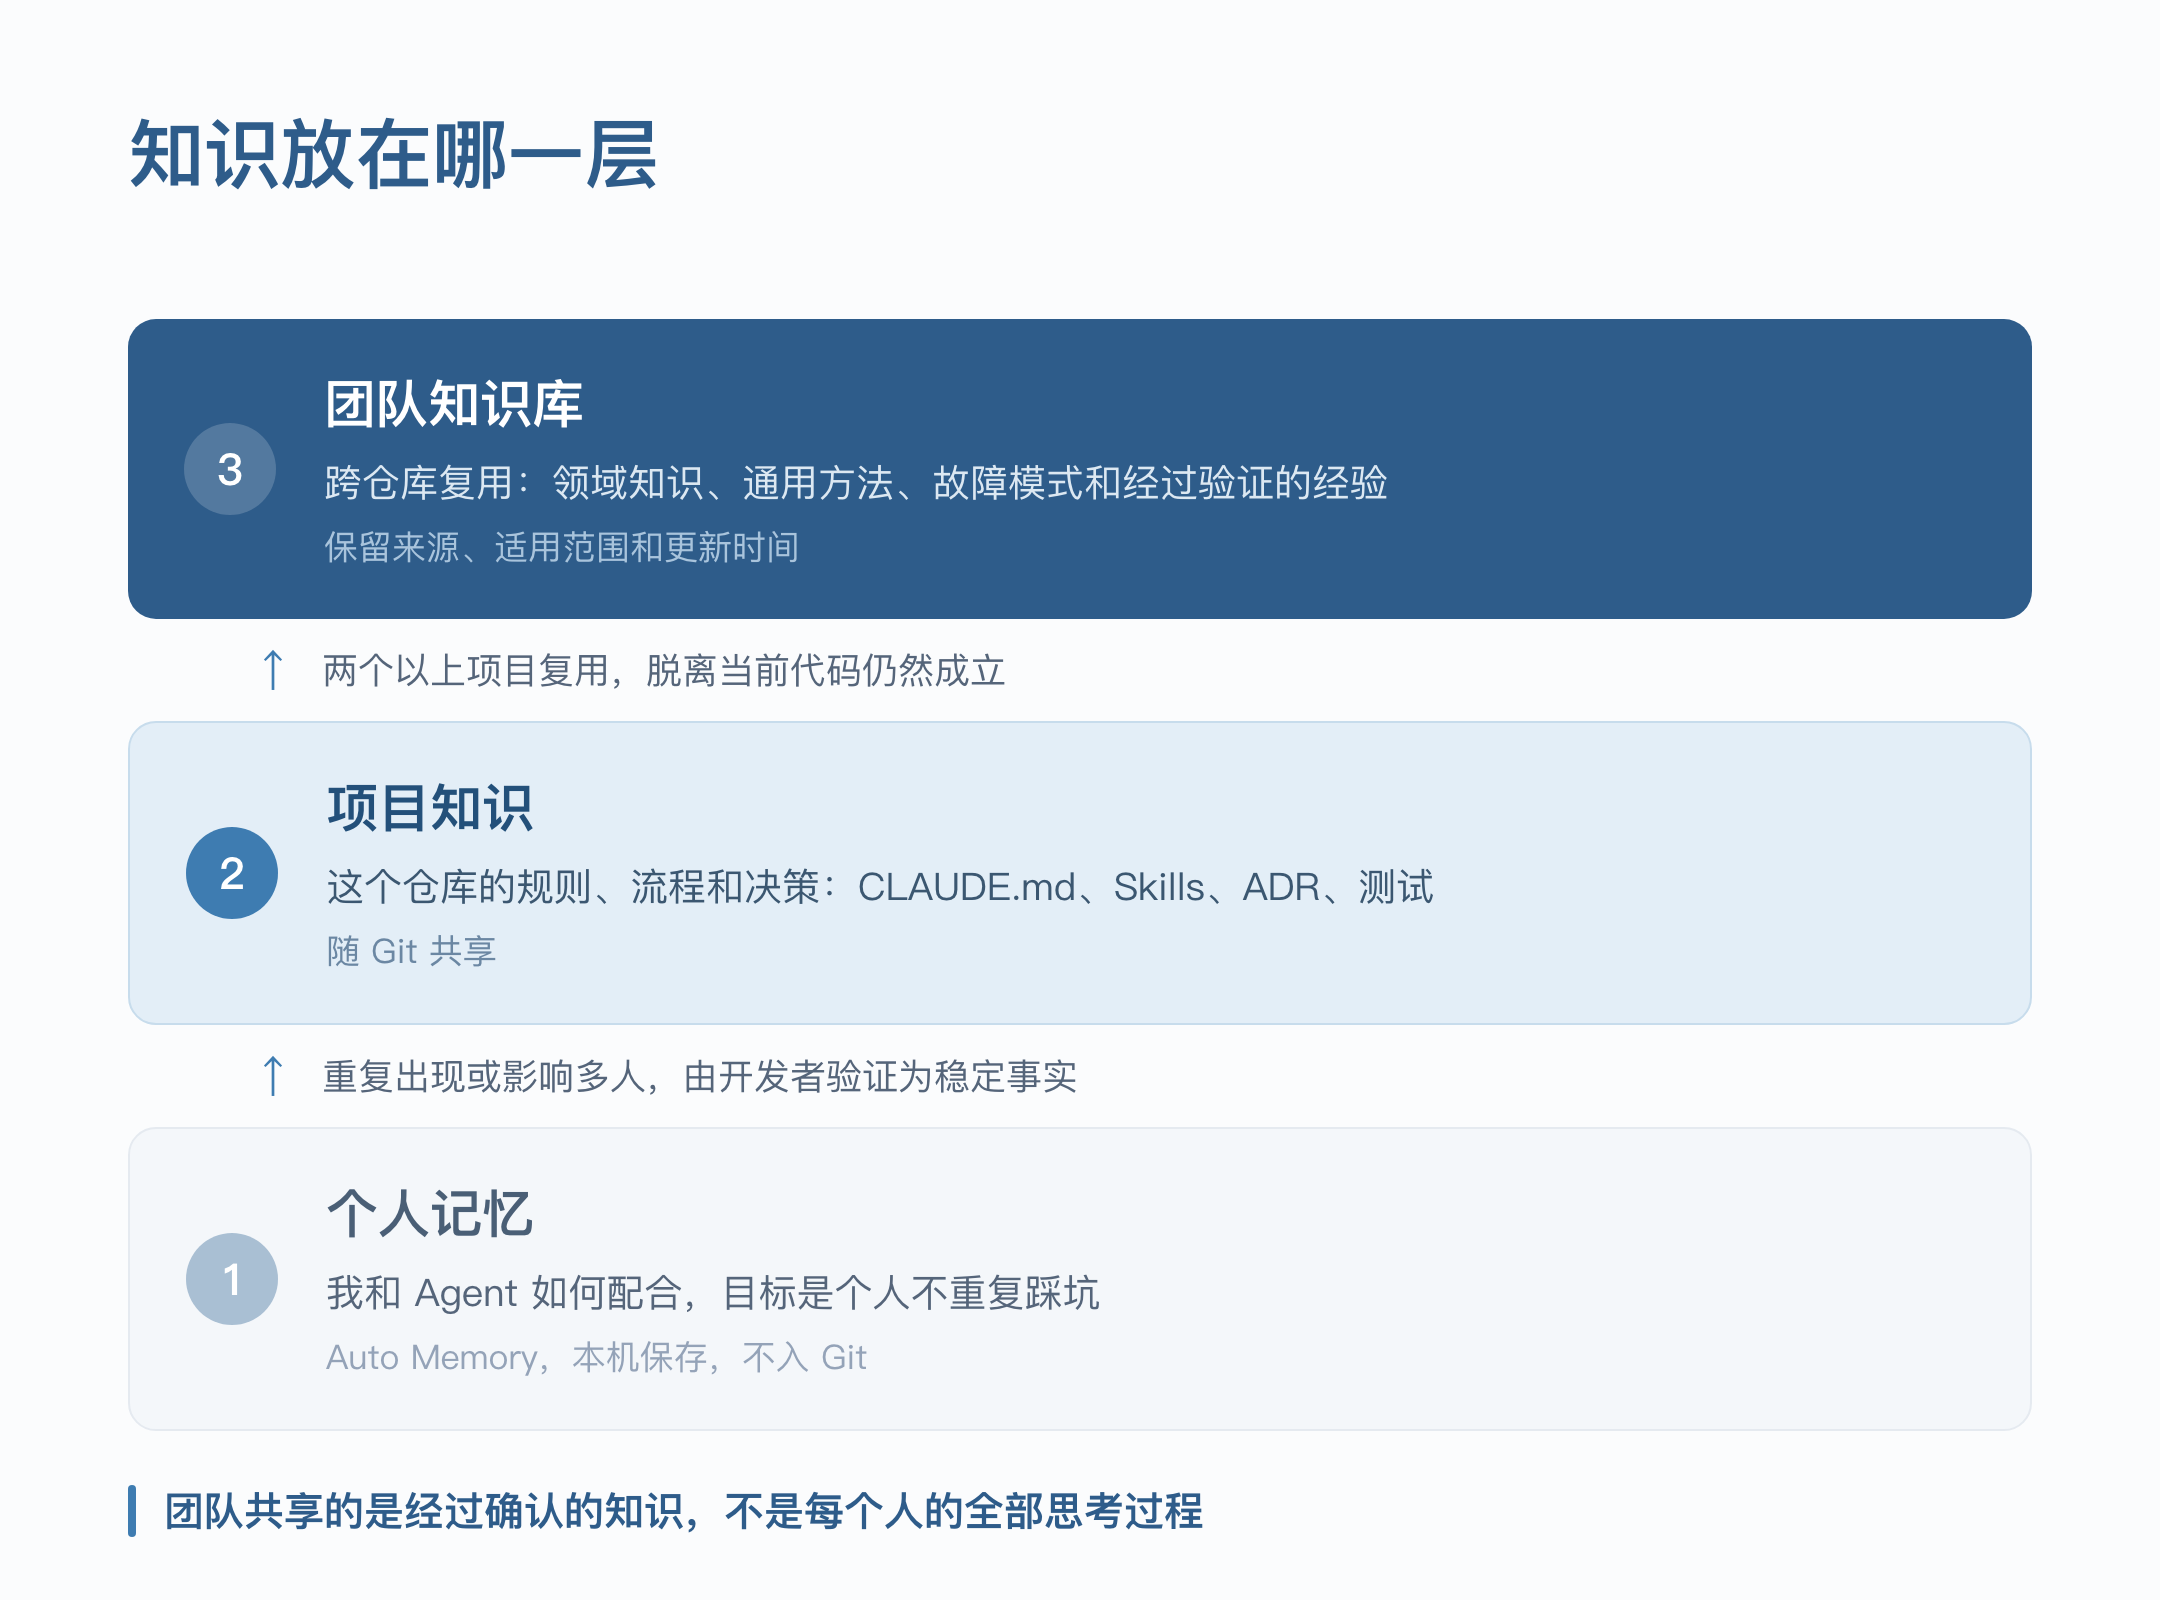
一条经验该不该从项目升级到团队知识库,可以问三个问题:它是否已经在两个以上项目中出现?新成员不知道它,是否会付出明显成本或带来风险?它是否脱离当前代码仍然成立?三条里命中两条,就值得进。
反过来,能从当前源码直接得到、或者只服务某次临时任务的信息,就不该进知识库。知识库最怕的不是少,而是把大量可重新获取、很快过期的信息固化进去。
知识库负责保存和组织,Skill 负责告诉 Agent 什么时候查、查什么,代码与测试负责给出最终证据。三者不能互相替代。
五、一套可以直接执行的分类标准
以后遇到一条新经验,我会按下面的顺序判断,而不是习惯性往 CLAUDE.md 追加一句话:先找到规则来源,再看能否自动验证,然后看作用范围,接着看风险等级,最后定期删除过期知识。
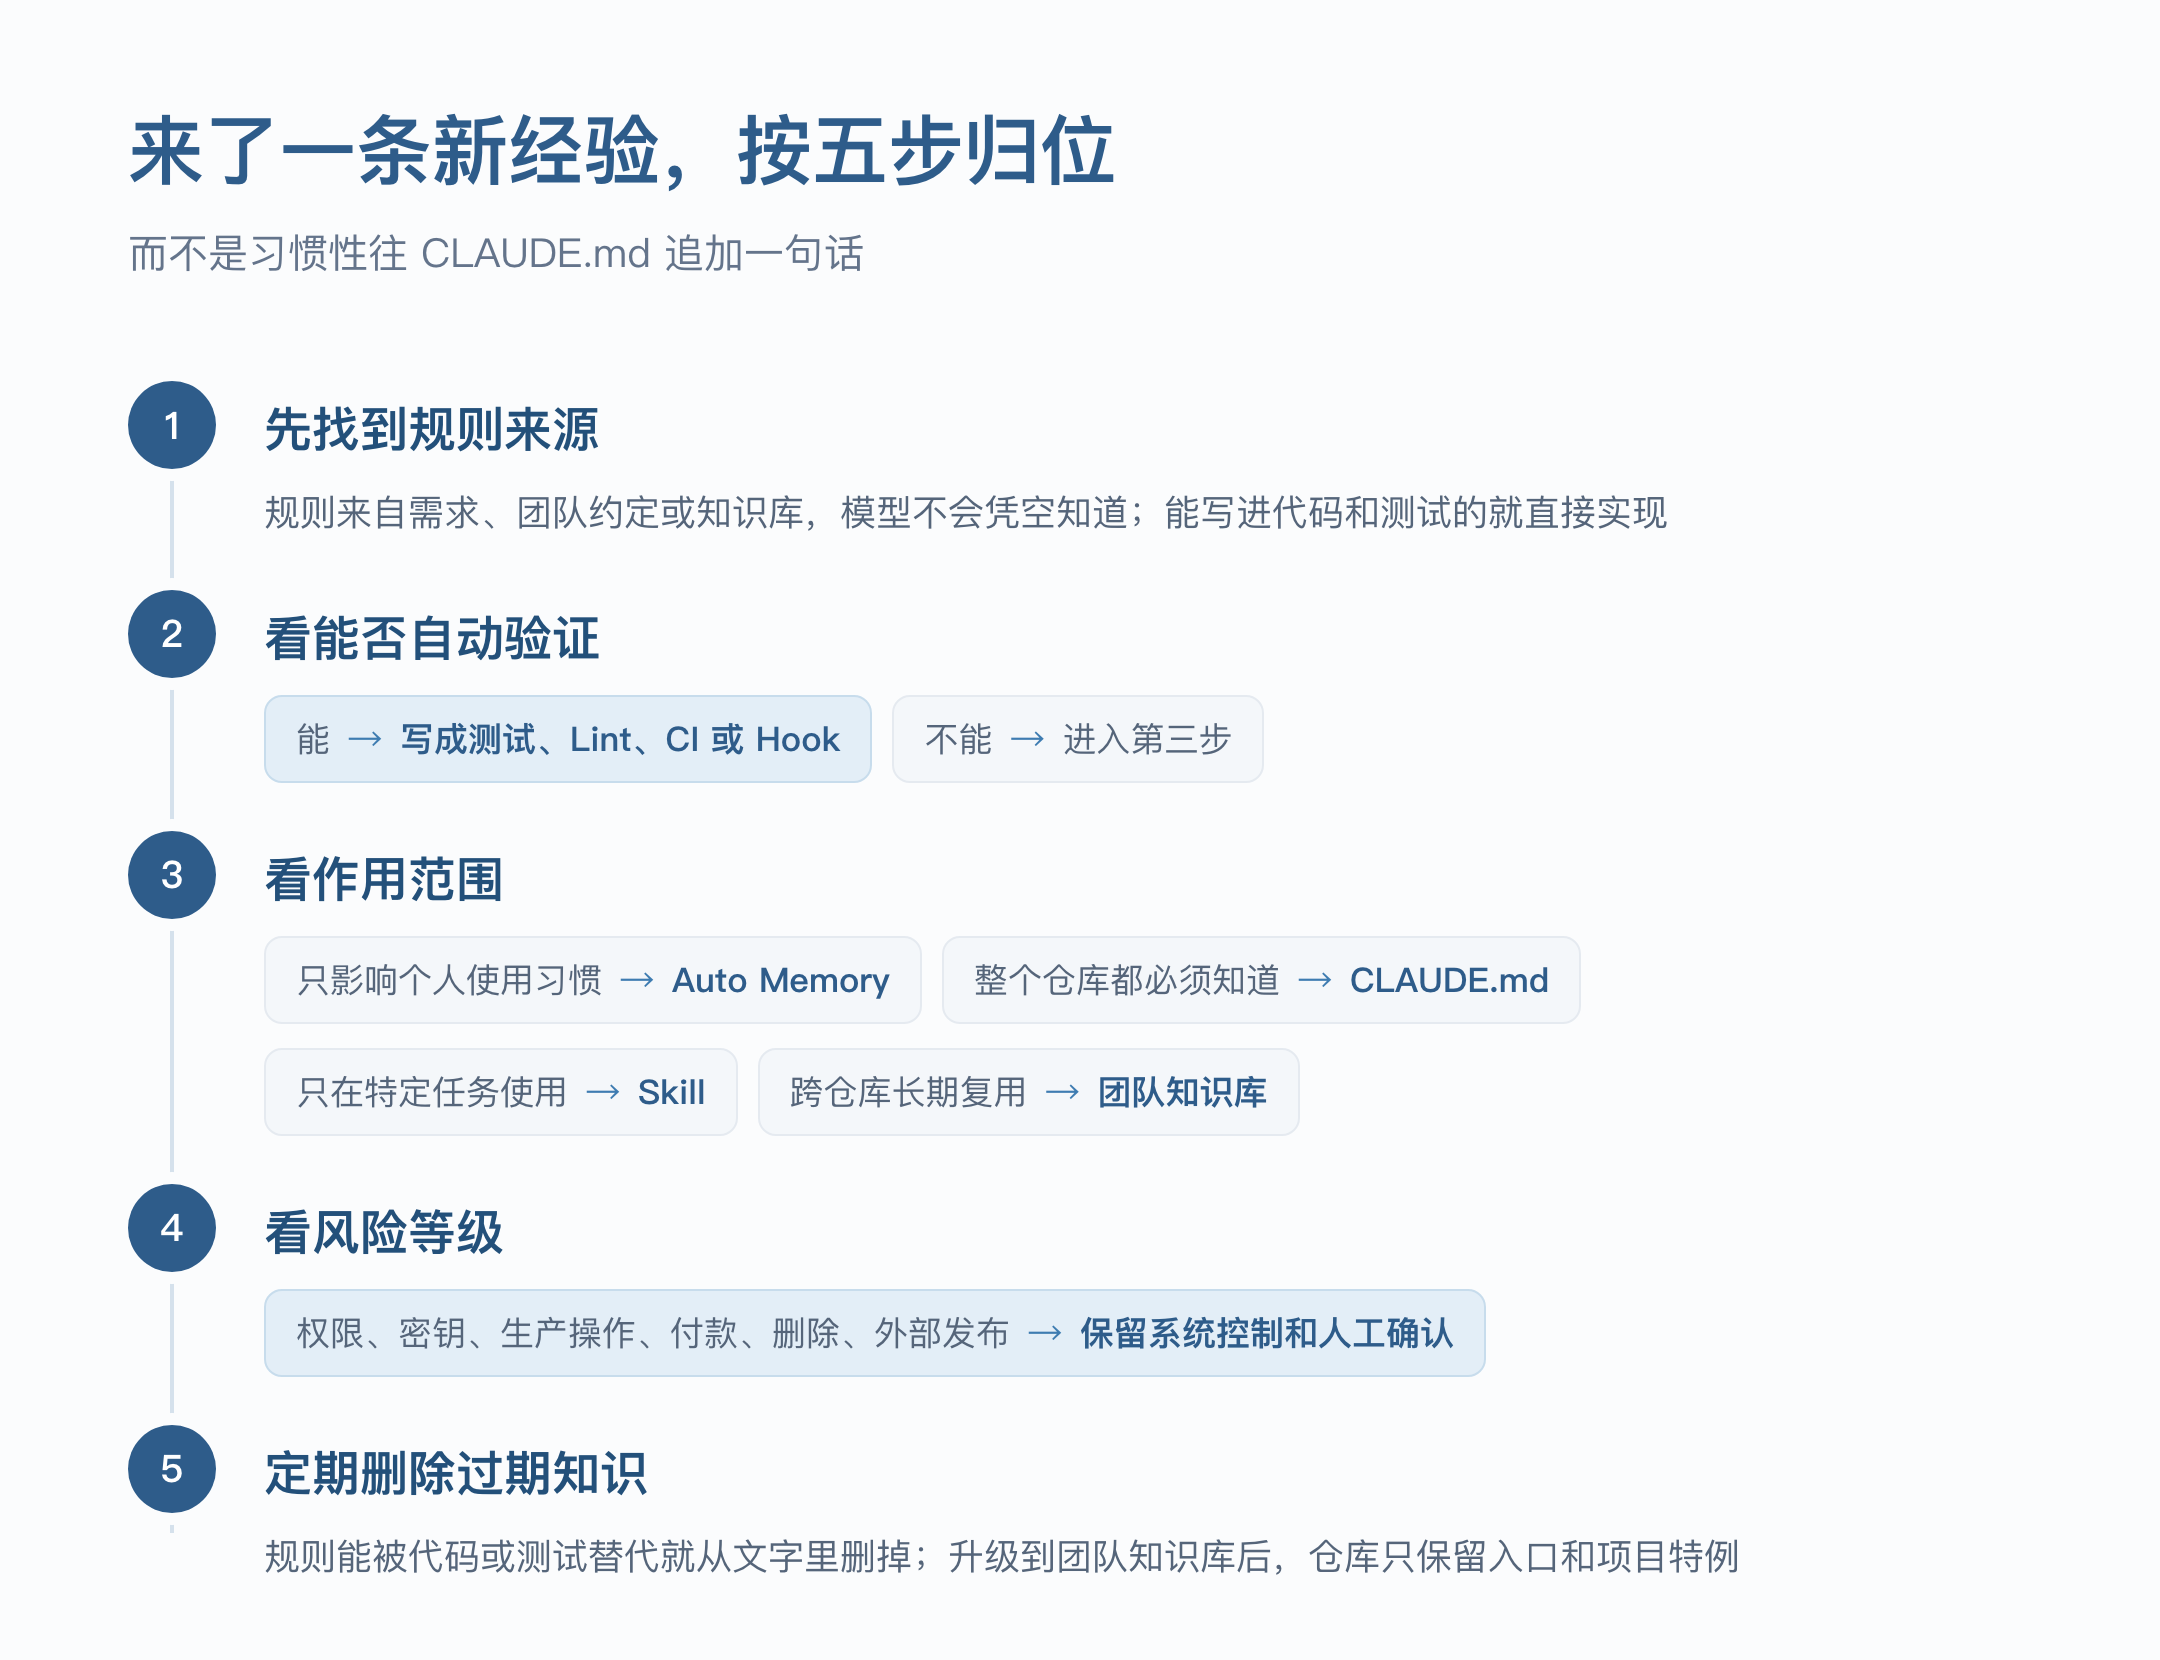
权限、密钥、生产操作、付款、删除和对外发布,不能依赖模型临场判断,必须保留明确的系统控制和人工确认。模型判断力提升可以省掉很多防呆规则,唯独省不掉这一类。
不想从头人工梳理,可以先运行 claude doctor。在 Claude Code 里执行 /doctor,它会检查你的 Skills 和 CLAUDE.md 并给出可以精简的地方。合理的用法是先跑一遍看它建议删什么,再按上面五步决定删掉的内容该搬去哪——工具负责找出冗余,搬家还得你自己判断。
文件长度只是结果,真正要治理的是重复、冲突、过时和放错位置的信息。
Anthropic 砍掉 80% 系统提示词,表面上是在做减法,背后却要求一套更完整的工程结构:清晰接口、按需加载的 Skills、独立记忆、可执行测试、权限控制,以及能被 Agent 检索的知识库。
模型越强,越不需要把所有答案提前写进提示词;但团队越依赖 Agent,越需要把知识放到正确的位置,并让重要约束能够被验证。
参考来源
[1]The new rules of context engineering for Claude 5 generation models: https://claude.com/blog/the-new-rules-of-context-engineering-for-claude-5-generation-models
[2]Claude Code Memory 官方文档: https://code.claude.com/docs/en/memory
首发于微信公众号「刘贺同学」 · 2026-07-28